14. سپتامبر 2026
Workload-Aware Scheduling در Kubernetes v1.37 به Beta رسید
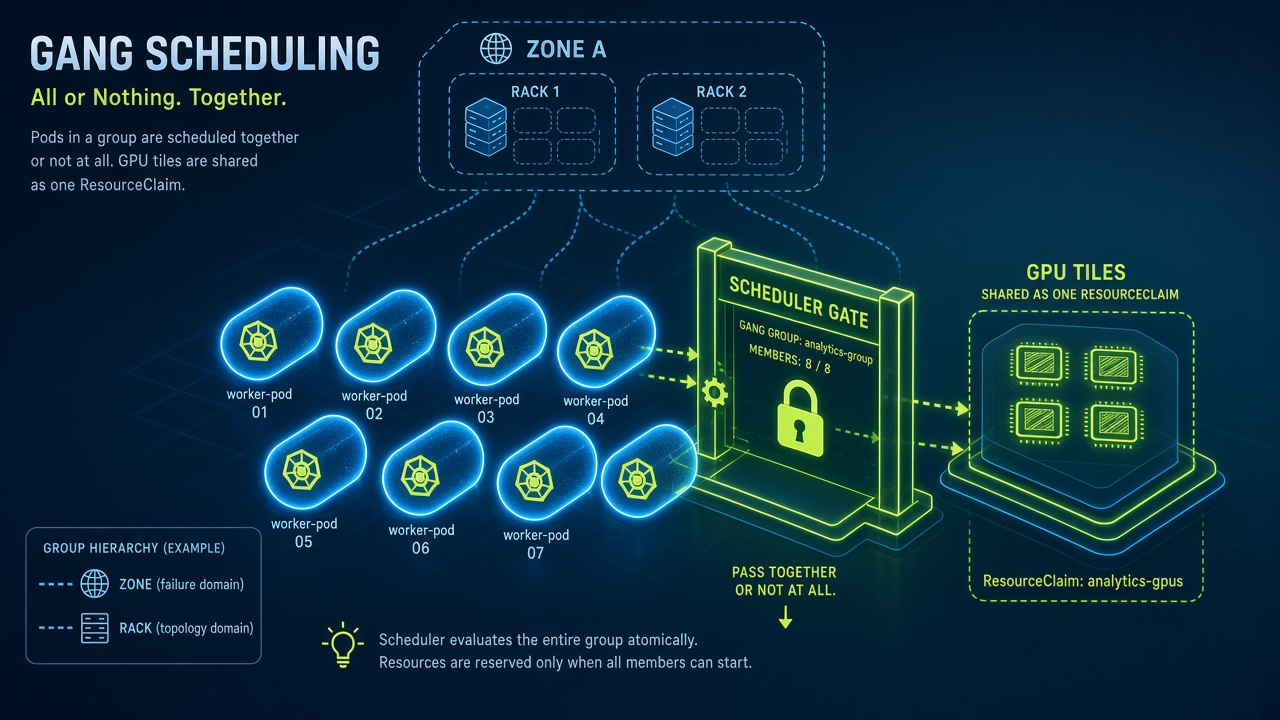
برای job توزیعشده — آموزش AI، MPI، خیلی از batchها — یا همه Podها با هم جا میشوند، یا هیچکدام. اگر scheduler چهار worker از هشت تا را بنشاند و GPU تمام شود، آن چهار تا فقط منابع را میسوزانند. اسم این ایده gang scheduling است.
تا امروز یا به schedulerهای خارجی (Volcano، Kueue، Coscheduling) تکیه میکردید، یا partial scheduling را با گوشت و پوست میدیدید. همزمان با ریلیز Kubernetes v1.37، تیم زمانبندی در پست ۸ سپتامبر نوشت که Workload-Aware Scheduling یک پله جلو آمده: مسیر native.
چه چیزی در v1.37 واقعاً Beta شد
- APIهای Workload و PodGroup (پایه gang scheduling) به Beta (
scheduling.k8s.io/v1beta1) رسیدند. - Workload-Aware Preemption دیگر feature gate جدا نیست و داخل
GenericWorkloadادغام شده. - DRA ResourceClaim اشتراکی برای PodGroup (
DRAWorkloadResourceClaims) به Beta رسیده. - API جدید CompositePodGroup برای سلسلهمراتب چندسطحی آمده (Alpha،
v1alpha3). - Job بومی فیلد
.spec.schedulingگرفته تا gang، topology و claim را صریح اعلام کند.
نکته عملی که از بقیه مهمتر است: Beta و Alpha این مجموعه بهصورت پیشفرض خاموشاند و باید feature gate را دستی روشن کنید. Beta بودن بهمعنی روشن شدن ناگهانی روی کلاستر production نیست.
در صف زمانبندی دیگر تکتک Podهای گروه جدا صف نمیشوند؛ خود PodGroup در صف است. minCount دیگر immutable نیست؛ controller میتواند حداقل اندازه gang را عوض کند بدون اینکه Podهای نشستهشده را قطع کند. نسخه آلفا v1alpha2 با v1alpha3 عوض شده و روی disruptionMode breaking change دارد — اگر از آلفا تست میکردید، manifest را باید بهروز کنید. نام حالتهای disruption هم عوض شده: PodGroup → all، Pod → single تا با CompositePodGroup یکدست باشد. اگر PodGroupPreemptionPolicy روشن باشد، خود PodGroup فیلد preemptionPolicy دارد و مرجع این است که گروه اجازه preemption دارد یا نه.
درخت گروه و یک ResourceClaim برای همه
Workloadهای واقعی اغلب تخت نیستند: یک driver، چند worker، گاهی چند سطح topology (منطقه، رک). CompositePodGroup درخت گروه میسازد. Scheduler کل درخت را یک واحد میبیند: یا سیاست ریشه (مثلاً minGroupCount) ارضا میشود و bind اتمی است، یا هیچ Podی bind نمیشود.
مثال رایج: کل workload داخل یک zone، و worker/driver داخل یک rack. این همان چیزی است که JobSet و LeaderWorkerSet معمولاً بالای Kubernetes میسازند؛ WAS میخواهد بخشی از آن را native کند.
برای GPU و منابع DRA، v1.36 گیت DRAWorkloadResourceClaims را آورده بود تا یک ResourceClaim برای کل PodGroup replicate/reserve شود و اعضا share کنند. در v1.37 این گیت Beta شده. یک تغییر رفتاری مهم: اگر گیت خاموش باشد و Pod و PodGroup هر دو به یک ResourceClaimTemplate اشاره کنند، دیگر برای هر Pod جدا claim ساخته نمیشود (رفتار قبلی میتوانست سیل claim بسازد و منبع DRA را تمام کند). حالا در آن حالت اصلاً claim ساخته نمیشود.
کتابخانه workloadbuilder هم آمده تا controllerهای خارج از درخت بتوانند همین مدل را در API خودشان embed کنند. Job اولین مصرفکننده in-tree است.
Working Group برای v1.38 از GA شدن Workload/PodGroup، Beta شدن TAS و CompositePodGroup، و همترازی با Kueue حرف زده است. هنوز GA نشده، CompositePodGroup هنوز Alpha است، و گیتها پیشفرض off هستند. یعنی الان وقت آزمایش روی کلاستر تست است، نه روشن کردن خاموش روی production بدون برنامه.